EKS Hybrid Nodes

온프레미스를 EKS로 확장하는 가이드

Block 1: 개요 & 아키텍처 | 30분

오늘 세션 구성

총 120min 세션

1
개요 & 아키텍처 30분
2
네트워킹 & Hybrid Nodes Gateway 30분
3
노드 부트스트랩 & 라이프사이클 30분
4
운영, 워크로드, 보안 & 전략 30분
질문은 각 Block 종료 시에 받겠습니다.

온프렘 K8s, 왜 아직도 힘든가

컨트롤 플레인 직접 운영
etcd 백업, 복구, API server 가용성, 인증서 갱신을 팀이 직접 책임
버전 업그레이드 부담
마이너 버전마다 컨트롤 플레인과 노드를 순서대로 올려야 하고, 실패 시 영향 범위가 큼
클러스터 파편화
클라우드와 온프렘이 서로 다른 도구, 정책, 버전으로 따로 운영되기 쉬움
인증, 감사 이원화
IAM 기반 클라우드 권한 체계와 온프렘 인증 체계를 각각 관리
GPU, 데이터 근접성
기존 하드웨어와 대규모 로컬 데이터 때문에 워크로드를 클라우드로 옮기기 어려움
가시성 도구 분산
모니터링, 로깅이 환경별로 나뉘어 한 화면에서 보기 어려움

Edge 옵션, 책임 경계가 다르다

옵션컨트롤 플레인워커 노드인프라 소유
EKS (클라우드)AWS 관리AWS Region의 컴퓨팅AWS
EKS on Local ZonesAWS 관리 (Region)Local Zone의 AWS 인프라AWS
EKS on Outposts확장 클러스터는 Region, 로컬 클러스터는 Outposts에서 AWS 관리고객 시설에 설치된 AWS 인프라AWS 제공
EKS Anywhere고객이 직접 운영고객 인프라고객
EKS Hybrid NodesAWS 관리 (EKS)고객 소유 온프레미스, 엣지 호스트고객
Local Zone, Outposts, 다른 클라우드의 머신을 hybrid node 인프라로 등록하는 것은 지원하지 않습니다. 테스트 목적으로 Amazon EC2에서 실행하는 것도 미지원이며 hybrid node 요금이 부과됩니다. 이 비교는 개념 수준이며, 상세 지원 범위는 각 서비스의 공식 문서로 확인하세요.

컨트롤 플레인만 AWS에 맡긴다

What
온프레미스, 엣지 노드를 AWS 관리형 EKS 컨트롤 플레인에 연결하는 기능
Why
클라우드와 온프렘을 같은 EKS API, 같은 도구로 운영하고 컨트롤 플레인 운영 부담을 줄임
단, 책임은 남는다
Host, OS, 연결, 워크로드 운영은 계속 고객 몫
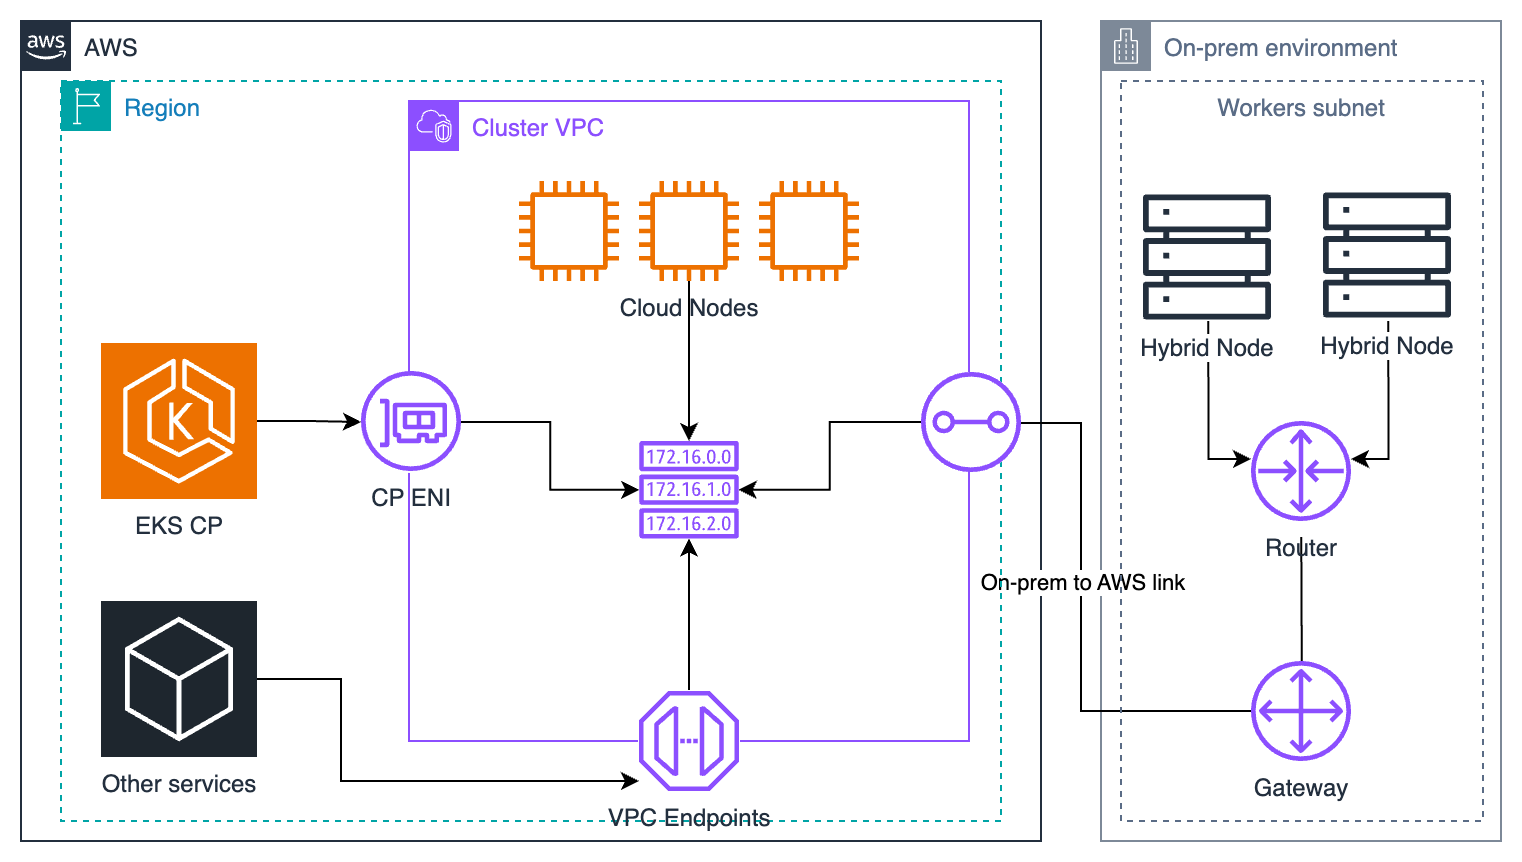
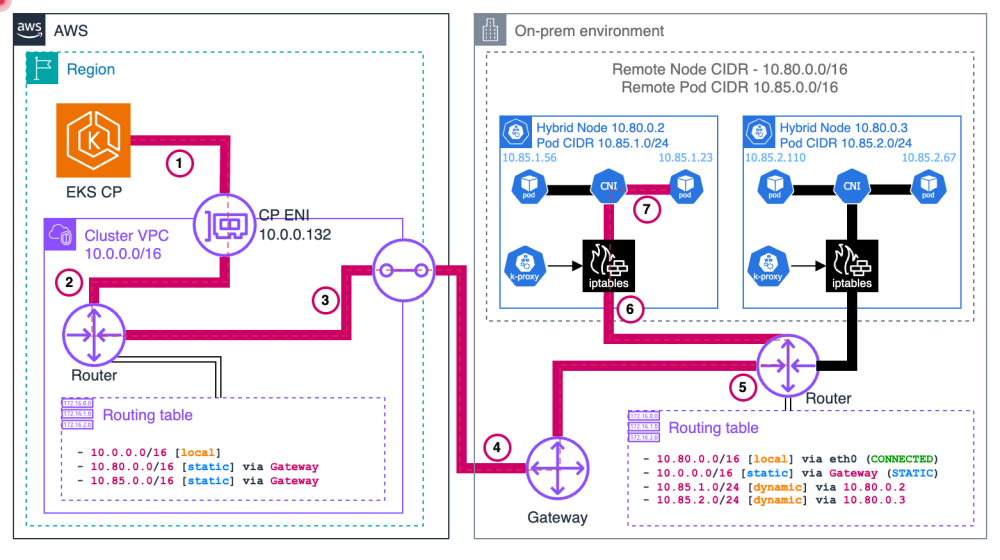
AWS 컨트롤 플레인 ENI와 온프레미스 하이브리드 노드를 연결하는 네트워크 개요

Ready까지 여섯 단계

1nodeadm install, init
의존성 설치와 구성. nodeadm은 상시 에이전트가 아닌 설치/bootstrap/upgrade CLI
2자격 증명 획득
SSM 또는 IAM Roles Anywhere로 임시 자격 증명 확보 (AWS 연결 필요)
3kubelet 기동
label eks.amazonaws.com/compute-type=hybrid 자동 부여, taint는 자동 아님
4EKS API 인증
Node IAM role의 HYBRID_LINUX access entry로 system:node 신원 매핑
5CNI 설치
Cilium 또는 Calico 필요. VPC CNI는 hybrid node를 관리하지 않음
6Ready
Pod 스케줄 가능. Pod Identity 등 add-on은 별도 구성

책임은 나뉘고, 데이터는 AWS에

AWS 책임
  • EKS API server, etcd, scheduler, controller
  • SSM / IAM Roles Anywhere 서비스
  • 컨트롤 플레인 가용성 관리
고객 책임
  • Host, OS, 보안 패치, kubelet, containerd 운영
  • CNI 구성, VPN, Direct Connect, 라우팅
  • 노드 인증서, 자격 증명 준비, 워크로드 운영
데이터 경계 주의: Secrets, Kubernetes 객체, 로그 등 컨트롤 플레인 데이터는 AWS에 저장됩니다. Private endpoint를 쓴다고 망분리 규정 준수가 입증되지는 않으며, Direct Connect 자체는 기본 암호화를 제공하지 않습니다.

도입 전 꼭 확인할 6가지 제약

IPv4 전용
Remote node, Pod CIDR은 RFC1918 또는 CGNAT(100.64.0.0/10)이며 VPC, service CIDR과 겹치면 안 됨
CIDR 개수 상한
클러스터당 remote node CIDR 15개, remote Pod CIDR 15개까지. 기존 클러스터에도 추가 가능
연결형 환경 전제
AWS와 안정적인 private 양방향 연결 필요. 단절, 간헐 연결(DDIL) 용도 아님
권장 연결 품질
일반 권장: 100 Mbps 이상, RTT 200 ms 이하 (엄격한 최소값은 아님)
API endpoint는 하나만 권장
Public-only 또는 Private-only 권장. "Public and Private"는 VPC 밖 노드에서 endpoint가 public IP로 해석되어 join이 실패할 수 있음
노드는 유휴여도 과금
Join부터 제거까지 vCPU-hour로 과금. Workload가 idle이어도 자동 중단되지 않음

지원 매트릭스: OS, K8s, CNI

OS지원 범위
Ubuntu20.04, 22.04, 24.04
RHEL8, 9
Amazon Linux 2023온프렘 가상화 환경만 (베어메탈 아님)
BottlerocketVMware 변형 v1.37.0+, x86_64만, nodeadm 미사용

아키텍처는 x86_64와 arm64. RHEL 10과 Ubuntu 26.04는 지원 목록에 없음.

항목내용
K8s 버전EKS와 동일한 버전 지원 (기준일 2026-10-07: 표준 1.34–1.37, 확장 1.31–1.33)
nodeadm현재 v1.0.20, SSM 사용 시 1.0.19 이상 필요
설치 권장releases/latest 대신 릴리스를 고정하고 checksum 검증
리전GovCloud (US), 중국 리전을 제외한 모든 AWS 리전
업그레이드 주의1.35 cgroup v2 필수, 1.36 containerd 2.0+, 1.37 SELinuxMount 기본 활성, kubelet flag 변경 (Block 3 점검 슬라이드)
항목내용
AWS 지원 범위AWS 빌드 oci://public.ecr.aws/eks/cilium/cilium
공식 CNI 페이지v1.17.x, v1.18.x 명시 (Gateway 사용 시 최소 1.17.13-1, 1.18.8-1, 1.19.2-1)
커널Cilium 1.18.3은 kernel 5.10+ 필요 → Ubuntu 20.04, RHEL 8 미지원
주의업스트림 최신 Cilium이 자동으로 AWS 지원 대상은 아님
지원 범위IPv4, VXLAN, Cluster Scope IPAM 등

자격 증명: SSM vs IAM RA

세션 수명
고정 1시간, SSM이 자동 갱신
Activation
기본 24시간, 최대 30일, RegistrationLimit 1–1000
노드 이름
SSM이 생성하는 mi-... 이름
언제 선택
기존 PKI가 없고 간단한 등록이 필요할 때

요금은 vCPU-hour 구간제

월 누적 vCPU-hours 구간vCPU-hour당 요금
처음 576,000$0.020
다음 576,000$0.014
다음 4,608,000$0.010
다음 5,760,000$0.008
11,520,000 초과$0.006
노드가 join된 시점부터 제거될 때까지 과금되며 workload가 idle이어도 요금은 유지됩니다.
과금은 Kubernetes에 보고된 vCPU 기준이고, Hyperthreading된 bare-metal core는 vCPU 2개로 보고될 수 있습니다. 머신당 32 vCPU 초과 시 account team과 상담하세요.
모든 사용량에 적용되는 고정 요금이 아닙니다. 클러스터 요금, 네트워크, 로그, 스토리지, OS 요금은 별도입니다.

내 환경 비용 직접 계산해보기

10
128코어
과금 기준: 256 vCPU/노드
GPU 서버 가정: 물리 CPU 32~216코어, 기본 128코어, SMT 해제 시 코어당 1 vCPU
-
월 vCPU-hours
-
월 노드 요금
-
연환산 노드 요금
-
연환산 + 클러스터 1개
공개 요율 기반 계산, 32 vCPU/머신 초과는 account team에 요금 확인, 실제 노드가 보고한 CPU 수 기준
추정치입니다. 월 730시간, 동일 리전, 계정 합산, 같은 월을 12번 반복한 연환산입니다. 마지막 카드는 표준 지원 클러스터 1개($876/년)를 더합니다. GPU 구매, 전력, 네트워크, 로그, 스토리지, EC2, OS, 인력 비용은 제외입니다.

Join 전 사전 준비 체크리스트

  • Access entry: node IAM role에 HYBRID_LINUX 타입 생성
    { "clusterName": "my-hybrid-cluster", "principalArn": "arn:aws:iam::123456789012:role/EKSHybridNodeRole", "type": "HYBRID_LINUX" }
  • remoteNetworkConfig: remote node, Pod CIDR 선언 (기존 클러스터에도 추가 가능)
    remoteNetworkConfig: remoteNodeNetworks: - cidrs: [10.80.0.0/16] remotePodNetworks: - cidrs: [10.85.0.0/16]
  • IAM: eks:DescribeCluster 포함 (AmazonEKSWorkerNodeMinimalPolicy에는 없음)
  • CIDR: IPv4, RFC1918/CGNAT, VPC, service CIDR과 중복 없음
  • 연결: TGW/VGW 양방향 라우팅, 443 / 10250 / webhook 포트 방화벽
  • OS: 지원 OS, nodeadm 버전, containerd source 확인

Block 1 퀴즈 (1/2)

Q1: SSM hybrid activation을 쓸 때 자격 증명 세션 수명은?
Q2: 지원 OS에 대한 설명으로 옳은 것은?

Block 1 퀴즈 (2/2)

Q3: Hybrid Nodes 요금 구조로 옳은 것은?
Q4: 클러스터 API endpoint 설정으로 옳은 것은?

References & Q&A

Overview
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-overview.html
nodeadm
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-nodeadm.html
Networking
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-networking.html
OS, Credentials
hybrid-nodes-os.html, hybrid-nodes-creds.html
CNI, Troubleshooting
hybrid-nodes-cni.html, hybrid-nodes-troubleshooting.html
Pricing
aws.amazon.com/eks/pricing

Thank You

Block 1: 개요 & 아키텍처 완료

← 목차로 돌아가기 다음: 네트워킹 & Gateway →

Block 2: 네트워킹 & Hybrid Nodes Gateway

누가 세션을 열고, Pod CIDR은 어떻게 도달하며, Gateway는 언제 쓰는가

연결이 먼저, 쿠버네티스는 그다음
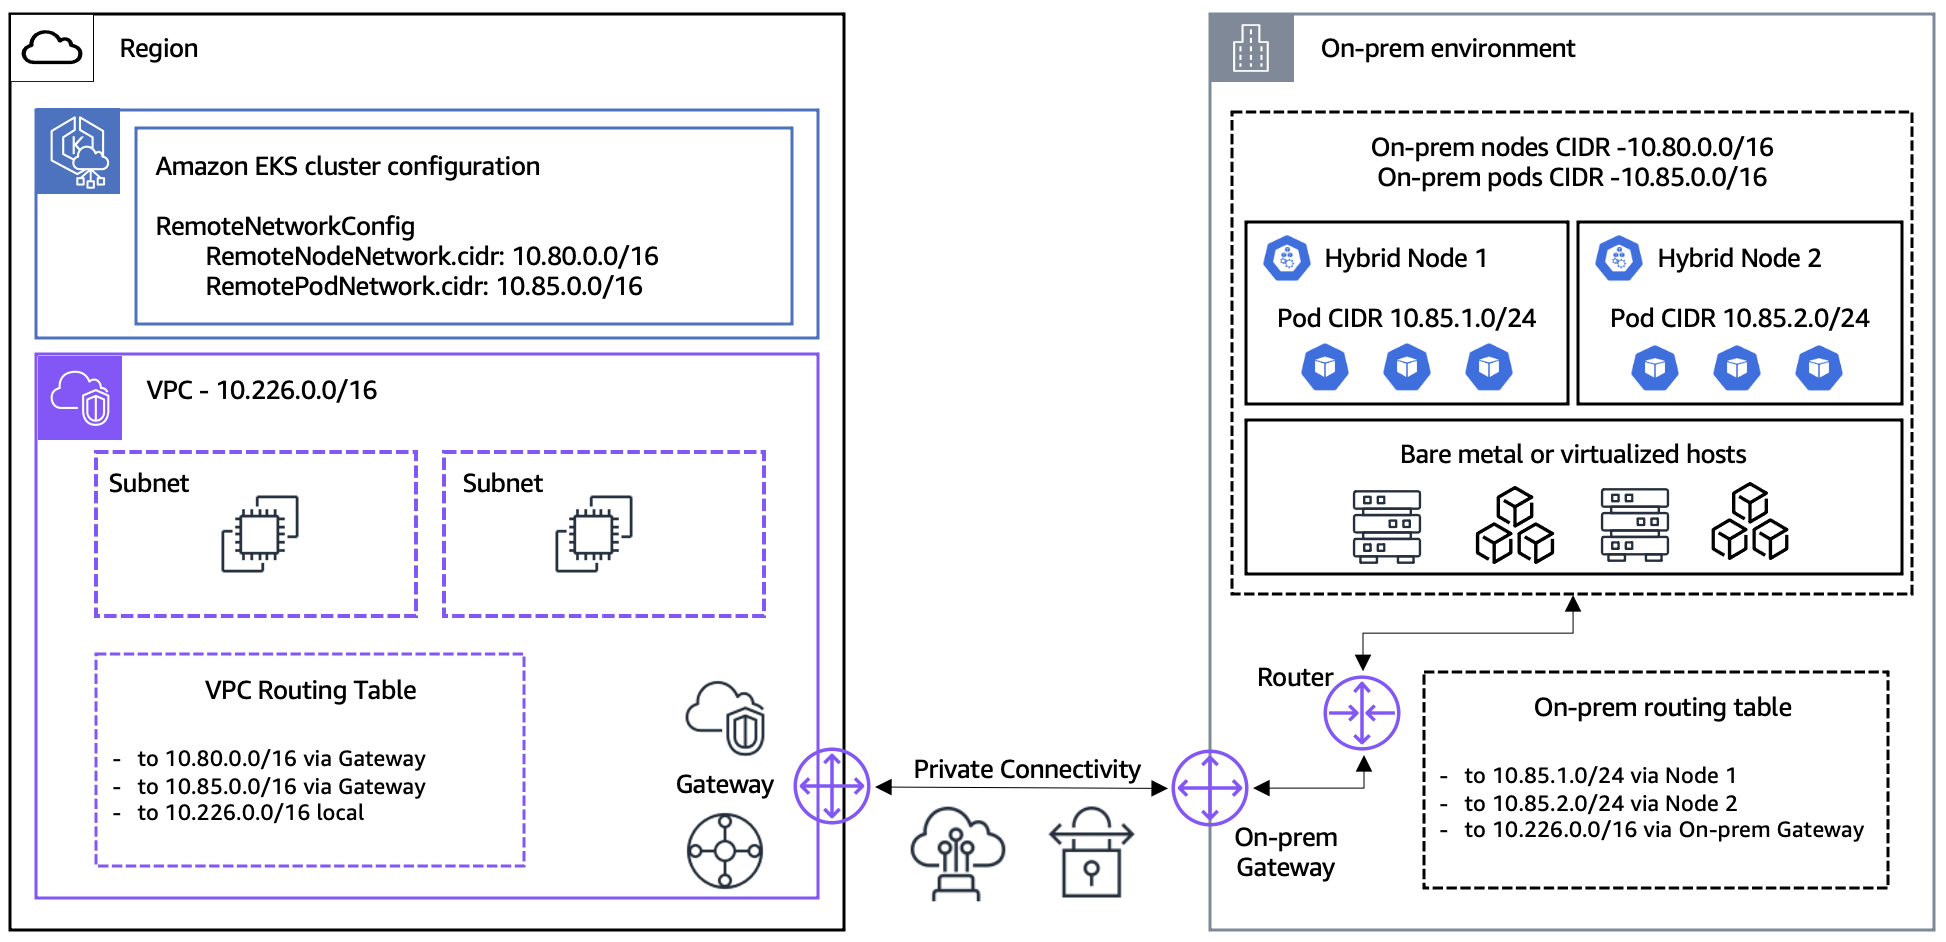
Hybrid Nodes 사전 조건: RemoteNetworkConfig, VPC 라우팅 테이블, 사설 연결, 온프렘 라우팅 테이블
그림의 Gateway = VGW/TGW 같은 사설 연결 게이트웨이입니다. 뒤에 나올 Hybrid Nodes Gateway와는 다른 물건입니다.
사설 연결
Direct Connect 또는 Site-to-Site VPN. 공용 인터넷 경로와 사설 경로를 구분해 설계
권장 품질
대역폭 ≥100 Mbps, RTT ≤200 ms (AWS 일반 권장, 보장값 아님)
양방향 route
VPC → remote node/Pod CIDR, 온프렘 → VPC CIDR. 한쪽만 있으면 join 후 logs/exec가 막힘

CIDR 설계: 겹치면 모든 게 막힌다

  • Remote node CIDR 최대 15개, remote Pod CIDR 최대 15개
  • IPv4 전용, RFC1918 또는 CGNAT(100.64.0.0/10) 범위
  • node/Pod CIDR끼리, 그리고 VPC, Service CIDR과도 겹치지 않을 것
  • 기존 클러스터에도 remote network 구성을 추가할 수 있음 (생성 시점 전용 아님)
    "remoteNetworkConfig": { "remoteNodeNetworks": [{ "cidrs": ["10.80.0.0/16"] }], "remotePodNetworks": [{ "cidrs": ["10.85.0.0/16"] }] }
  • Pod CIDR을 라우팅 가능하게 만들지(BGP/static) 결정, webhook, Cloud↔Hybrid Pod 통신이 여기에 달림
  • Cilium cluster-pool: 기존 항목, MaskSize 변경 금지, 확장은 새 항목 추가 (Cilium 문서 기준)

443은 안에서 열고, 10250은 밖에서 온다

Hybrid Nodes 고수준 네트워크: EKS CP, CP ENI, VPC, VPC 엔드포인트, 온프렘 노드와 라우터
그림 속 Gateway도 사설 연결 게이트웨이입니다 (Hybrid Nodes Gateway 아님).
온프렘이 연다 (outbound)
kubelet, Pod → Kubernetes API, TCP 443. 노드가 먼저 연결을 시작
AWS가 연다 (inbound)
CP → kubelet TCP 10250 (logs/exec/port-forward), CP → webhook Pod의 실제 설정 port
응답 허용 ≠ 신규 inbound 허용
443 세션의 stateful return이 10250 신규 연결을 열어 주지 않음. 별도 방화벽 규칙 필요

kubelet과 CP, 세션 방향이 다르다

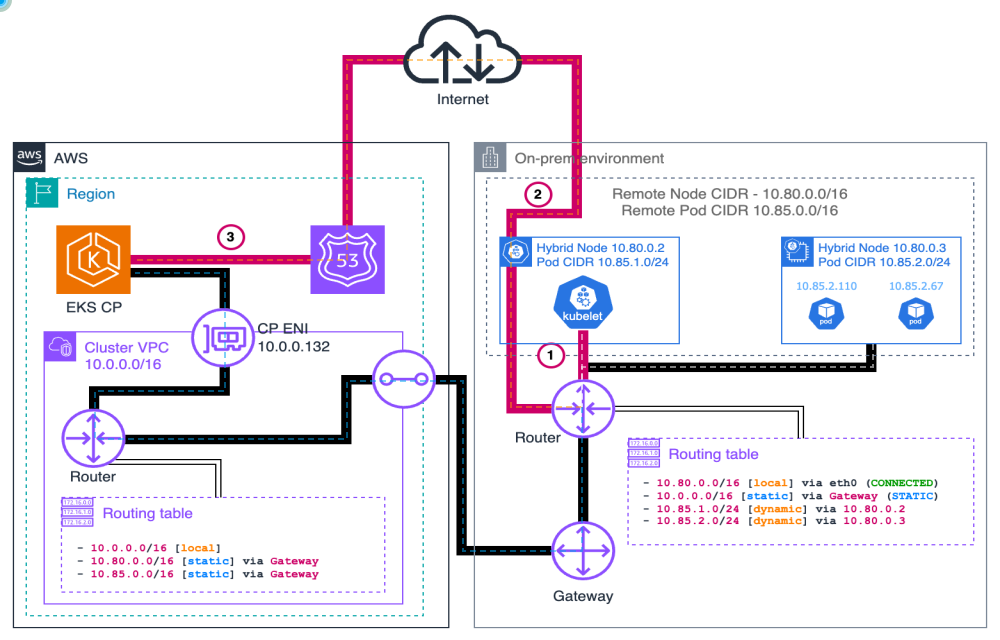
kubelet에서 EKS 컨트롤 플레인으로: public endpoint 경로와 private endpoint 경로
public/private 중 하나를 선택: 경로가 다르므로 endpoint 설정에 따라 방화벽, DNS가 달라집니다. EKS 관리 PrivateLink(eks)와 Kubernetes API endpoint는 별개입니다.
한 줄 정리
443은 온프렘이 열고, 10250은 CP가 엽니다, 같은 노드라도 방화벽 규칙의 방향이 다릅니다.

Pod→API: Service 변환과 SNAT

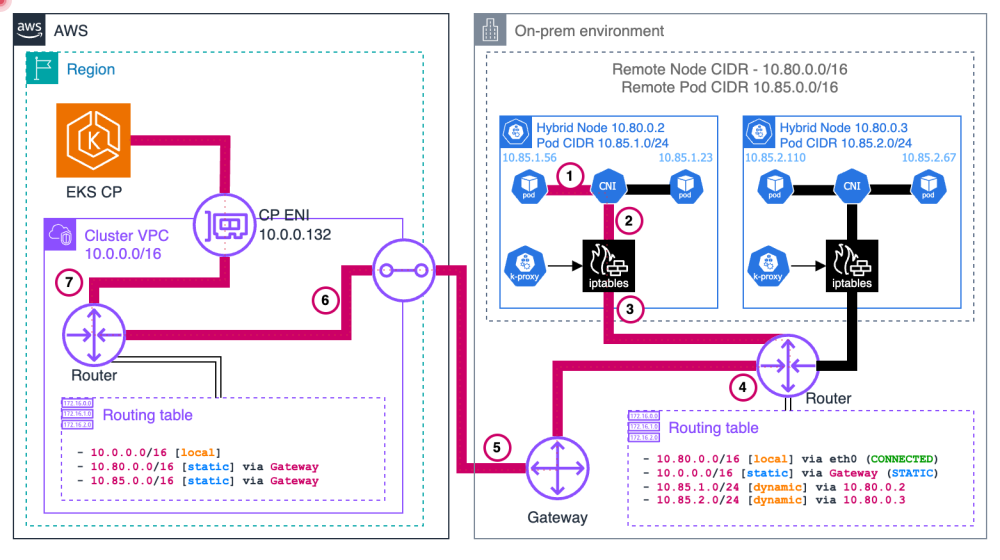
Pod에서 EKS 컨트롤 플레인으로: CNI NAT 있음/없음 경로
그림은 kube-proxy/iptables 기준의 설명용입니다. Cilium eBPF kube-proxy replacement에서는 처리 방식이 다르고, 번호도 보편적 hook 순서가 아닙니다.
SNAT 있음
응답이 node 주소로 돌아오고 conntrack이 역변환. Pod CIDR return route 불필요
SNAT 없음
Pod 주소 그대로 나가므로 VPC → Pod CIDR return route 필요 (routable Pod 설계)
Service IP를 쓰는 Pod는 선택한 API endpoint로의 Service 변환이 먼저 일어남

웹훅: CP가 Pod IP로 직접 들어온다

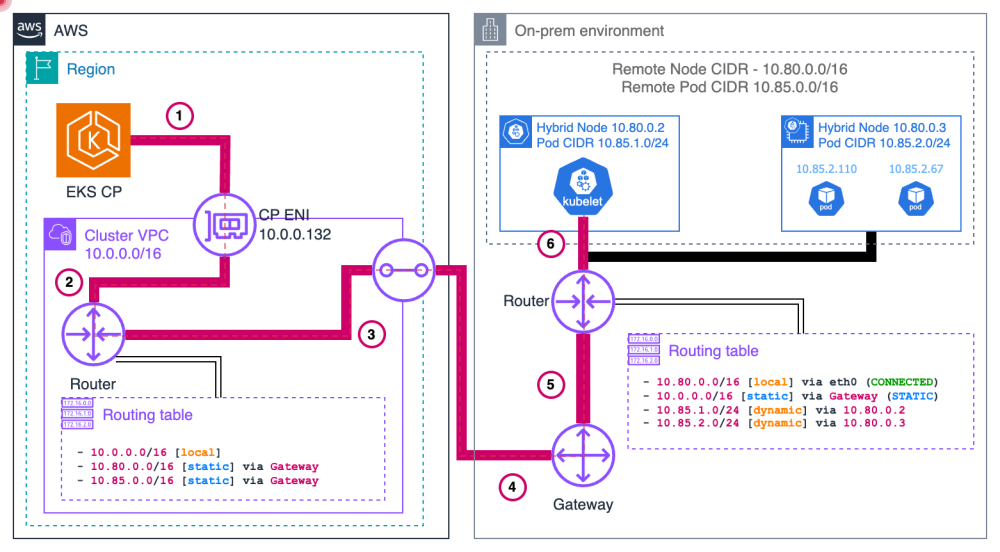
EKS 컨트롤 플레인에서 webhook Pod로: VPC 라우팅, 사설 연결, 온프렘 라우터, CNI
Pod CIDR route가 있어야 합니다. CP ENI → VPC route → 사설 연결 → 온프렘 라우터 → node → Pod. 포트는 실제 설정한 webhook port이며 "8443 이상 전체"가 아닙니다.
한 줄 정리
CP가 Pod에 닿지 못하면 해당 webhook 호출이 실패합니다, Pod route를 만들거나(BGP/static/Gateway) webhook을 cloud에 두세요.

Pod 간 통신: VXLAN과 Cloud↔Hybrid

node 1
Pod A
10.85.1.x
Cilium VXLAN encap
→ UDP 8472 →
underlay (outer packet)
src node 1 IP
dst node 2 IP
→
node 2
Cilium decap
Pod B
10.85.2.x
outer packet은 node IP로 라우팅됩니다. 캡슐화 운반만을 위해 underlay에 Pod CIDR route가 필요하지는 않습니다(같은 L2 node끼리는 router hop 없이 직접 통신할 수도 있음). IPv4 VXLAN overhead 50바이트 → MTU 1500이면 1450 예시. 이 UDP 8472는 direct routing, Gateway 두 모드 모두에서 필요합니다.
한 줄 정리
UDP 8472는 어느 모드에서든 열려 있어야 합니다 (hybrid 노드 간 VXLAN).

라우팅 선택: static, BGP, Gateway

비교 항목static routeCilium BGP v2Gateway
Pod CIDR 도달 방법온프렘 라우터에 node별 prefix를 수동 등록Cilium이 Pod CIDR을 라우터에 광고pod CIDR당 VPC route 1건 → leader ENI + VXLAN
온프렘 라우터 변경필요 (route 유지, drift 추적)필요 (peering, ASN, prefix filter)Pod CIDR route는 불필요 (node IP, UDP 8472은 필요)
CNI 제약지원되는 routable Pod 설계Cilium BGP Control PlaneAWS Cilium VTEP + l7Proxy=false
HA / 처리량네트워크 팀 설계, 라우터/링크 한계네트워크 팀 설계, 라우터/링크 한계Lease active-standby, 활성 Gateway 1대 한계
정리(제거)소유한 route 정리소유한 route/peering 정리Helm 제거해도 VPC route는 남음
BGP 우선
라우터 팀이 BGP를 운영할 수 있고 노드가 늘어날 환경. AWS 가이드가 권장하는 방식
static은 소규모, 고정 환경
노드, Pod CIDR 변경 때마다 수동 갱신과 장애 추적 부담
Gateway는 라우터 변경이 어려울 때
VTEP/l7Proxy=false 제약과 추가 hop을 수용할 수 있다면

Cilium BGP v2: Pod CIDR만 광고

hybrid 노드를 선택해 라우터와 peering (localASN = Cilium node, peerASN = 온프렘 라우터)

apiVersion: cilium.io/v2alpha1 kind: CiliumBGPClusterConfig metadata: name: hybrid-bgp-config spec: nodeSelector: matchLabels: eks.amazonaws.com/compute-type: hybrid bgpInstances: - name: hybrid-instance localASN: 65001 peers: - name: on-prem-router peerASN: 65000 peerAddress: 10.80.1.1 peerConfigRef: name: on-prem-peer

timer와 graceful restart, 광고 selector 연결

apiVersion: cilium.io/v2alpha1 kind: CiliumBGPPeerConfig metadata: name: on-prem-peer spec: timers: holdTimeSeconds: 90 keepAliveTimeSeconds: 30 gracefulRestart: enabled: true restartTimeSeconds: 120 families: - afi: ipv4 safi: unicast advertisements: matchLabels: advertise: hybrid-pods

Pod CIDR만 광고 (Service, LB IP는 별도 설계)

apiVersion: cilium.io/v2alpha1 kind: CiliumBGPAdvertisement metadata: name: hybrid-pod-cidrs labels: advertise: hybrid-pods spec: advertisements: - advertisementType: PodCIDR

Helm values로 BGP Control Plane 활성화 후 상태 확인

bgpControlPlane: enabled: true operator: rollOutPods: true
cilium bgp peers cilium bgp routes

Gateway는 Pod CIDR 라우팅 숙제를 던다

GA 2026-04-21 오픈소스 (Apache-2.0) Gateway 추가 요금 없음 선택 사항
가능하게 해 주는 흐름
CP → webhook
hybrid Pod의 webhook 호출
Cloud ↔ Hybrid Pod
양방향 Pod IP 통신
ALB/NLB IP target
VPC → hybrid Pod 등록
AMP managed collector
private cluster endpoint 필요
솔직한 한계
설치만으로 모든 조건이 충족되지 않음, route, return path, TLS, 방화벽은 별도 검증
AWS Cilium + VTEP, l7Proxy=false 필요 (Cilium Ingress/Gateway API/L7 policy와 같은 설치에서 충돌)
VXLAN은 암호화 없음, 클러스터당 1개, 활성 Gateway 1대가 처리량 한계

Gateway 데이터 플레인: 한 경로로 읽기

Amazon VPC① VPC
Cloud Pod / CP / ALB
dst = Hybrid Pod IP
route table
hybrid pod CIDR마다 1건 → leader ENI
(ReplaceRoute)
→
Amazon EC2② Gateway leader (EC2)
hybrid_vxlan0, VNI 2
UDP 8472, IP 없음
CiliumNode watch →
로컬 FDB, ARP, onlink route
→
AWS Direct Connect
AWS Site-to-Site VPN
DX/VPN
③ 온프렘
Cilium agent (VTEP)
decap
Hybrid Pod
역방향
leader가 CiliumVTEPConfig hybrid-gateway(tunnelEndpoint, cidr, mac)를 갱신 → Cilium이 VPC CIDR 목적지를 VXLAN으로 leader에 전송
두 종류의 상태
AWS route는 pod CIDR당 1건(노드가 늘어도 그대로), 노드별 터널 정보는 각 replica가 CiliumNode watch로 로컬에서 갱신

Gateway HA: active/standby, scale-up

① 갱신 실패
leader가 Lease 갱신 못함
renew deadline 2s
→
② 인계
Lease 만료 3s
standby가 획득 (retry 1s)
→
③ route
ReplaceRoute →
새 leader ENI
→
④ VTEP
CiliumVTEPConfig
IP, MAC 갱신
3–5초는 가이드, 보장 아님
AWS 안내 예상치. AWS 블로그 측정은 약 6.2초. API, route, Cilium, 앱 복구를 실제로 검증
replica는 처리량이 아님
standby는 터널 상태만 warm 유지. 처리량은 인스턴스 크기를 키워(scale-up) 해결
2 AZ에 2대
chart는 host 분리 필수, AZ 분리 선호. AWS 가이드: 10–100 노드 c6in.xlarge, 더 크면 c6in.2xlarge/4xlarge

Gateway 설치: 노드→IAM→VTEP→Helm

Auto Mode NodeClass의 source/dest check 해제 (필드 발췌)

# NodeClass.spec advancedNetworking: sourceDestCheck: DisabledPrimaryENI

NodePool 쪽은 Gateway 노드에 label을 붙입니다 (chart nodeLabel과 일치)

# 노드 label hybrid-gateway-node: "true"

NodePool은 label hybrid-gateway-node: "true"와 taint hybrid-gateway-node:NoSchedule을 사용합니다(전체 manifest는 AWS getting-started 문서). 관리형/자체 관리 노드는 primary ENI source/dest check를 별도로 끄고 autoMode.enabled=false

aws eks create-pod-identity-association \ --cluster-name "$CLUSTER_NAME" --namespace eks-hybrid-nodes-gateway \ --service-account eks-hybrid-nodes-gateway --role-arn "$GATEWAY_ROLE_ARN" \ --no-disable-session-tags # 필요 권한 4개: ec2:DescribeRouteTables, DescribeInstances, CreateRoute, ReplaceRoute kubectl -n kube-system set env daemonset/aws-node \ AWS_VPC_K8S_CNI_EXCLUDE_SNAT_CIDRS="$SNAT_EXCLUDE_CIDRS"

SNAT_EXCLUDE_CIDRS는 기존 제외 범위와 모든 hybrid Pod CIDR의 합집합입니다. Auto Mode는 aws-node DaemonSet이 없고, serviceAccount.annotations는 1.0.2에서 무시됩니다.

helm upgrade cilium oci://public.ecr.aws/eks/cilium/cilium \ --version "$CILIUM_VERSION" --namespace kube-system --reuse-values \ --set vtep.enabled=true --set l7Proxy=false kubectl -n kube-system rollout restart daemonset/cilium kubectl -n kube-system get configmap cilium-config \ -o jsonpath='{.data.enable-vtep}{"\n"}{.data.enable-l7-proxy}{"\n"}' # 기대 출력: true / false

AWS Cilium 최소 버전: 1.17.13-1, 1.18.8-1, 1.19.2-1. Cilium minor를 바꾸는 업그레이드에서는 --reuse-values를 주의하세요.

# values.yaml (podCIDRs, routeTableIDs는 CSV 문자열) vpcCIDR: "10.226.0.0/16" # 예시 값 podCIDRs: "10.85.0.0/16" routeTableIDs: "rtb-0abc123456789def0,rtb-0def456789abc1230" replicas: 2 nodeLabel: hybrid-gateway-node autoMode: enabled: false # Auto Mode 노드는 true
helm upgrade --install eks-hybrid-nodes-gateway \ oci://public.ecr.aws/eks/eks-hybrid-nodes-gateway \ --version 1.0.2 --namespace eks-hybrid-nodes-gateway --create-namespace \ --values values.yaml

Gateway 운영: 관측과 제약

메트릭 (포트 10080 /metrics)의미 / 쓰는 법
hybrid_gateway_leader_is_activereplica의 leader 여부. sum()이 1이어야 하며 route 성공의 증거는 아님
hybrid_gateway_hybrid_nodes_configuredreplica별 로컬 구성 노드 수 (leader+standby 합산 금지)
hybrid_gateway_vxlan_{tx,rx}_{bytes,packets}_totalCounter, rate()로 처리량 확인
hybrid_gateway_aws_route_table_update_errors_totalCounter, increase(…[5m])로 최근 실패만 판단
health는 TCP 8088 /healthz, /readyz. chart는 Service, ServiceMonitor, PDB를 만들지 않으므로 직접 구성하고, readiness만으로 forwarding 성공을 판단하지 마세요.
한 줄 정리
설치, 제거는 결국 route 소유권 문제입니다, 바꾸기 전에 table, CIDR, target을 기록하세요.

방화벽 규칙: 모드별로 달라진다

Flow포트시작 주체
Node/Pod → Kubernetes APITCP 443 (실제 endpoint)온프렘
CP ENI → kubeletTCP 10250AWS (inbound)
CP → webhook/aggregated API Pod실제 설정한 TCP portAWS (inbound)
DNS client ↔ 실제 resolverUDP/TCP 53구성별
hybrid 노드 간 Cilium VXLANUDP 8472 (Geneve 선택 시 UDP 6081)노드
Cilium healthTCP 4240 (+ICMP)노드
VPN을 쓰면 UDP 500/4500. 광범위한 허용(10.0.0.0/8 등)이나 인증 없는 kubelet 10255는 열지 마세요.
한 줄 정리
먼저 '누가 시작하는가'로 방향을 정하고, 모드별 추가 포트만 더하세요.

VPC 엔드포인트: 쓰는 만큼만

eks
DescribeCluster 등 EKS 관리 API (Kubernetes API endpoint와 다름)
ssm, ssmmessages
SSM 하이브리드 활성화를 쓸 때 (SSM provider)
rolesanywhere
IAM Roles Anywhere provider를 쓸 때
한 줄 정리
엔드포인트 목록은 provider와 사용 기능을 정한 뒤에 확정하세요.

Block 2 Quiz (1/2)

Q1: kubectl logs, exec가 동작하려면 온프렘 방화벽에서 무엇을 허용해야 하는가?
Q2: UDP 8472 규칙은 언제 필요한가?

Block 2 Quiz (2/2)

Q3: helm uninstall 후 Gateway가 남기는 것은?
Q4: Gateway와 BGP 선택에 대한 설명으로 맞는 것은?

공식 문서로 이어가기

네트워킹 요구 사항
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-networking.html
CNI, Cilium BGP
…/hybrid-nodes-cni.html
…/hybrid-nodes-cilium-bgp.html
Webhook 배치
…/hybrid-nodes-webhooks.html
Gateway 문서
…/hybrid-nodes-gateway-overview.html
…/hybrid-nodes-gateway-getting-started.html
…/hybrid-nodes-gateway-operations.html
Gateway 소스
github.com/aws/eks-hybrid-nodes-gateway
AWS Containers 블로그
Simplify hybrid Kubernetes networking with Amazon EKS Hybrid Nodes gateway

Thank You

Block 2: 네트워킹 & Gateway 완료

← 목차로 돌아가기 다음: 노드 부트스트랩 →

Block 3: 노드 부트스트랩 & 라이프사이클

사전 준비 → nodeadm → Cilium → 업그레이드 → 트러블슈팅 → 크리덴셜

조인 전에 끝낼 AWS 사전 준비

노드 IAM 역할에 HYBRID_LINUX 타입 access entry를 만듭니다. 일반 SSM 관리 역할만으로는 조인되지 않습니다.

{ "clusterName": "my-hybrid-cluster", "principalArn": "arn:aws:iam::123456789012:role/EKSHybridNodeRole", "type": "HYBRID_LINUX" }
  • 매핑은 system:node:{{SessionName}} + node-bootstrap 그룹 사용
  • 기존 mapping을 지우는 한-role aws-auth ConfigMap은 적용하지 않기

클러스터 생성 시 원격 노드/Pod CIDR을 선언합니다. 기존 클러스터에도 remote network 구성을 추가할 수 있습니다.

# ClusterConfig 중 hybrid 관련 부분 remoteNetworkConfig: iam: provider: SSM roleARN: arn:aws:iam::123456789012:role/EKSHybridNodeRole vpcGatewayID: tgw-0123456789abcdef0 remoteNodeNetworks: - cidrs: - 10.80.0.0/16 remotePodNetworks: - cidrs: - 10.85.0.0/16
  • CIDR은 IPv4, 종류별 최대 15개, RFC1918 또는 CGNAT(100.64.0.0/10)

AmazonEKSWorkerNodeMinimalPolicy만으로는 eks:DescribeCluster 권한이 없습니다. 역할에 직접 추가합니다.

{ "Effect": "Allow", "Action": "eks:DescribeCluster", "Resource": "arn:aws:eks:ap-northeast-2:123456789012:cluster/my-hybrid-cluster" }
  • SSM: ECR pull + SSM core + 등록 해제 권한 (ssm:DeregisterManagedInstance)
  • IAM Roles Anywhere: 프로필에 acceptRoleSessionName: true
  • Pod Identity는 eks-auth:AssumeRoleForPodIdentity를 별도로 부여

nodeadm: 명령은 여섯 개뿐

install
kubelet, containerd, SSM agent 등 의존성 설치
config check
로컬 NodeConfig 검사 (조인 시험 아님)
init
호스트 구성 + EKS 조인
upgrade
in-place 버전 변경 (중단 작업)
uninstall
구성 요소 제거 + SSM 등록 해제
debug
AWS/클러스터 연결, 자격 증명 진단
v1.0.20: 저장소 aws/eks-hybrid (EC2용 amazon-eks-ami의 nodeadm과 다름). SSM 신규 설치, 업그레이드는 1.0.19 이상 필요.
없는 것: upgrade --rollback, reset, init --dry-run은 존재하지 않습니다.
# releases/latest 대신 승인한 릴리스를 받고 체크섬을 검증한 뒤 설치 printf '%s %s\n' "$NODEADM_SHA256" "$STAGING_DIR/nodeadm" | sha256sum --check - sudo install -m 0755 "$STAGING_DIR/nodeadm" /usr/local/bin/nodeadm

부트스트랩은 다섯 걸음

1install
kubelet, containerd 등 의존성 설치. 등록은 하지 않음
2config check
NodeConfig 로컬 검사. 통과해도 조인을 보증하지 않음 (dry-run 아님)
3init
호스트 구성, SSM 등록 등 자격 증명 설정, EKS 조인
4CNI
CNI 설치 전까지 Node가 NotReady인 것은 정상일 수 있음
5Ready 검증
노드 UID 대조, 라벨, DNS, 이미지 풀, 자격 증명 갱신
Ready는 필요 조건일 뿐: 실제 워크로드까지 확인한 뒤에 서비스에 투입합니다.

NodeConfig는 공급자 하나로 충분

apiVersion: node.eks.aws/v1alpha1 kind: NodeConfig spec: cluster: name: my-hybrid-cluster region: ap-northeast-2 hybrid: ssm: activationCode: REPLACE_WITH_ACTIVATION_CODE activationId: REPLACE_WITH_ACTIVATION_ID kubelet: config: maxPods: 110 flags: - --node-labels=example.com/location=onprem

파일은 root 소유 0600으로 보호하고 활성화 코드를 로그에 남기지 않습니다. 등록 후 Node 이름은 mi-*입니다.

apiVersion: node.eks.aws/v1alpha1 kind: NodeConfig spec: cluster: name: my-hybrid-cluster region: ap-northeast-2 hybrid: iamRolesAnywhere: nodeName: hybrid-node-001 trustAnchorArn: arn:aws:rolesanywhere:ap-northeast-2:123456789012:trust-anchor/REPLACE_ID profileArn: arn:aws:rolesanywhere:ap-northeast-2:123456789012:profile/REPLACE_ID roleArn: arn:aws:iam::123456789012:role/EKSHybridNodeRole certificatePath: /etc/iam/pki/server.pem privateKeyPath: /etc/iam/pki/server.key
  • 필수 입력은 클러스터 이름 + 리전 + 공급자 블록
  • API 엔드포인트, CA, CIDR은 직접 쓰지 않습니다. 역할의 eks:DescribeCluster로 nodeadm이 조회합니다
  • IAM Roles Anywhere는 nodeName, certificatePath, privateKeyPath가 추가로 필요
  • nodeName은 인증서 CN과 역할 신뢰 정책 조건에 묶이며 최대 64자
  • 인증서 하나를 여러 머신에 재사용하지 않습니다

Bottlerocket은 nodeadm이 없다

범위 VMware variant, x86_64, OS 1.37.0+ (vSphere 전용)
방식 settings.toml + eks-hybrid-setup bootstrap container, guestinfo.userdata.encoding=base64

오른쪽은 공통 조각입니다. 공급자별 설정은 AWS 가이드에서 조합하고, api-server, CA는 자동 조회되지 않으므로 직접 기입합니다. 이 TOML은 join에 필요한 최소 설정이라 static IP 같은 네트워크 설정은 Bottlerocket 문서로 따로 검증하세요.

주의: base64는 암호화가 아닙니다. 활성화 비밀과 개인 키가 들어갈 수 있으니 VM 구성, guestinfo를 보호하고, 등록된 VM을 템플릿으로 복제하지 않습니다.

[settings.kubernetes] cluster-name = "my-hybrid-cluster" api-server = "https://REPLACE_WITH_CLUSTER_ENDPOINT" cluster-certificate = "REPLACE_WITH_BASE64_CLUSTER_CA" hostname-override = "hybrid-node-001" provider-id = "eks-hybrid:///ap-northeast-2/my-hybrid-cluster/hybrid-node-001" authentication-mode = "aws" cloud-provider = "" server-tls-bootstrap = true [settings.aws] region = "ap-northeast-2" [settings.kubernetes.node-labels] "eks.amazonaws.com/compute-type" = "hybrid" [settings.bootstrap-containers.eks-hybrid-setup] mode = "always" user-data = "REPLACE_WITH_BASE64_PROVIDER_BOOTSTRAP_INPUT"

containerd 소스는 OS가 정한다

Ubuntu / AL2023
distro (기본)
RHEL
docker 또는 none, distro는 무효
AL2023
docker 사용 불가
none
containerd 설치를 건너뜀, 미리 설치, 관리해야 함
sudo nodeadm install "$KUBERNETES_VERSION" \ --credential-provider "$CREDENTIAL_PROVIDER" \ --containerd-source "$CONTAINERD_SOURCE" --region "$REGION" --timeout 20m

베어메탈은 이미지로 찍어낸다

Packer
hybrid-nodes-template.pkr.hcl, vSphere OVA, QEMU qcow2/raw
Ubuntu Autoinstall
Subiquity YAML(cloud-init). 디스크는 승인한 serial로만 지정
RHEL Kickstart
ignoredisk와 clearpart를 같은 디스크로 제한
K8S_VERSION 검증: v1.0.20 템플릿은 1.26–1.31만 허용합니다. 템플릿 때문에 버전을 낮추지 말고 검토한 포크를 유지하세요.
export NODEADM_ARCH=amd # amd/arm (뒤에 64가 붙음) export CREDENTIAL_PROVIDER=ssm # ssm/iam (iam은 nodeadm의 iam-ra로 변환) export PACKER_OUTPUT_FORMAT=raw packer validate -syntax-only hybrid-nodes-template.pkr.hcl

Cilium: 하이브리드 노드에만 설치

affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: eks.amazonaws.com/compute-type operator: In values: [hybrid] ipam: mode: cluster-pool operator: clusterPoolIPv4MaskSize: 25 clusterPoolIPv4PodCIDRList: [10.85.0.0/16]
operator: affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: - matchExpressions: - key: eks.amazonaws.com/compute-type operator: In values: [hybrid] unmanagedPodWatcher: restart: false envoy: enabled: false kubeProxyReplacement: "false"
helm install cilium oci://public.ecr.aws/eks/cilium/cilium \ --version "$CILIUM_VERSION" --namespace kube-system \ --values cilium-values.yaml --wait --timeout 10m
  • AWS 지원 범위는 AWS 유지 관리 빌드(oci://public.ecr.aws/eks/cilium/cilium)
  • 공식 CNI 페이지: 1.17.x / 1.18.x (예: 1.17.9-0, 1.18.3-0)
  • Hybrid Nodes Gateway를 쓰면 branch별 VTEP 최소 1.17.13-1, 1.18.8-1, 1.19.2-1: 위 예시 버전으로는 Gateway 불가
  • 1.18.3은 커널 요구로 Ubuntu 20.04, RHEL 8 제외
  • 업스트림 최신 차트를 임의로 쓰지 않습니다

마스크가 노드당 Pod 수를 정한다

MaskSize전체 IPv4사용 가능 (−2 예약)maxPods 산정 예
/26646250
/25128126110
/24256254240
AWS 공식 가이드
설치 후 clusterPoolIPv4PodCIDRList와 MaskSize를 변경하지 않는다
Cilium 문서 기준
기존 항목, MaskSize는 수정 금지. 확장은 새 CIDR 항목 추가
산정 예일 뿐: maxPods 값은 검증된 권장값이 아닙니다. hostNetwork Pod, 데몬, CPU/메모리 여유를 함께 검토하세요.

라벨은 하나, 테인트는 없다

kubectl get nodes -l eks.amazonaws.com/compute-type=hybrid -o wide kubectl get node "$EXPECTED_NODE_NAME" --show-labels kubectl wait --for=condition=Ready "node/$EXPECTED_NODE_NAME" --timeout=5m kubectl -n kube-system get pods -o wide | grep cilium
자동 라벨
eks.amazonaws.com/compute-type=hybrid 하나뿐. --node-labels로 따로 넣을 필요 없음
추가 라벨
NodeConfig kubelet.flags의 --node-labels=...
테인트
자동 부여 없음. 선택 사항이며 쓰면 워크로드, CNI에 toleration 필요
kubectl taint nodes hybrid-gpu-001 gpu=true:NoSchedule # 운영 중 수동 테인트

kubelet 튜닝: 예약, 축출, maxPods

kubelet: config: systemReserved: cpu: "500m" memory: "1Gi" ephemeral-storage: "10Gi" kubeReserved: cpu: "500m" memory: "1Gi" ephemeral-storage: "5Gi"

Node Allocatable에서 차감하는 예약량입니다. OS, kubelet, 런타임, CNI 사용량을 측정해 정합니다. 위 값은 초기 산정 예입니다.

kubelet: config: evictionHard: memory.available: 200Mi nodefs.available: 10% imagefs.available: 15% nodefs.inodesFree: 5% imagefs.inodesFree: 5% evictionSoft: memory.available: 500Mi evictionSoftGracePeriod: memory.available: 1m30s

Hard 임계값은 유예 없이 처리됩니다. evictionHard를 바꾸면 inode 항목까지 전체 의도한 임계값을 명시하세요. 누락한 기본 임계값은 0이 됩니다.

kubelet: config: maxPods: 110 imageGCHighThresholdPercent: 85 imageGCLowThresholdPercent: 80 shutdownGracePeriod: 60s shutdownGracePeriodCriticalPods: 20s

maxPods는 Cilium 노드별 pool 크기(/25 → 사용 가능 126)와 함께 정합니다. 종료 유예 60초에는 critical Pod용 20초가 포함됩니다.

업그레이드는 교체가 기본이다

  • 권장: 새 호스트를 준비해 전환: 새 노드를 초기화, 검증한 뒤 이전 호스트를 비웁니다 (이전 호스트는 검증 완료까지 보존)
  • in-place: 비운(cordon + drain) 호스트에서 nodeadm upgrade 실행. 중단 작업이며 트랜잭션식 다운그레이드가 아님
  • kubelet은 API 서버보다 새 버전일 수 없고, n-3까지 뒤처질 수 있음 (계속 유지하라는 권장은 아님)
  • 뒤처진 노드를 먼저 현재 컨트롤 플레인 마이너로 맞춘 뒤, 다음 마이너는 컨트롤 플레인부터
sudo /usr/local/bin/nodeadm upgrade "$TARGET_MINOR" \ -c file:///etc/eks/nodeconfig.yaml --timeout 20m
  1. 현재 values, Helm revision 저장, 버전별 업그레이드 문서 확인
  2. Hybrid 노드로 한정한 별도 preflight 릴리스 실행 (preflight.enabled=true, agent=false, operator.enabled=false)
  3. DaemonSet 커버리지와 검증 Deployment readiness를 둘 다 대기
  4. 통과 후 preflight 릴리스만 제거
  5. 기존 values + 적절한 upgradeCompatibility로 업그레이드, 한 마이너씩

마이너 버전 사이에 --reuse-values를 쓰지 않습니다.

  • nodeadm upgrade --rollback은 없습니다
  • 실패 시 해당 노드의 cordon 유지, 나머지 작업 중단
  • 현재 컨트롤 플레인과 호환되는 승인된 이미지/버전의 호스트로 교체
  • /var/lib/kubelet, /etc/kubernetes 재귀 삭제는 롤백 단계가 아님
  • uninstall은 SSM 등록도 해제하므로 무조건 uninstall/reinstall 반복 금지
  • Cilium만 명시한 Helm revision으로 helm rollback 가능하나 데이터 경로 복구를 보장하지 않음 (CRD 호환성 검토 필요)

1.37 업그레이드 전 필수 점검

  • 1.37에서 SELinuxMount가 기본 활성화: SELinux가 켜진 노드(예: RHEL)만 영향
  • CSI driver가 seLinuxMount: true이고 Pod에 seLinuxOptions가 있으면 mount -o context=LABEL로 마운트
  • 같은 노드에서 한 volume을 다른 label, seLinuxChangePolicy, 권한 수준으로 공유하면 뒤에 뜬 Pod가 ContainerCreating에 멈춤
  • 공유 Pod끼리 seLinuxOptions.level과 seLinuxChangePolicy를 맞추고, privileged와 unprivileged가 섞이면 Recursive로 지정
kubectl get csidriver \ -o custom-columns=NAME:.metadata.name,SELINUXMOUNT:.spec.seLinuxMount
  • deprecated cAdvisor flag가 남아 있으면 kubelet이 기동하지 않음 (--housekeeping-interval만 예외)
  • eventRecordQPS: 0은 이제 무제한: 이전 동작(초당 5개)을 유지하려면 5로 변경
  • metric 제거: container_cpu_load_average_10s, container_cpu_load_d_average_10s, container_tasks_state → 대시보드, 알람 수정
  • kubelet이 시작할 때 전체 설정을 로그에 남김 → 노드 로그 읽기 권한 제한

"EKS 최적화 AMI는 영향 없음"은 Hybrid 노드에 해당하지 않습니다. NodeConfig의 kubelet.flags, kubelet.config와 골든 이미지에 넣은 인자를 점검합니다.

  • 1.35: cgroup v1 노드에서 kubelet 기동 거부 (기본값), Ubuntu 20.04, RHEL 8은 기본이 cgroup v1
  • 1.35: kubelet --pod-infra-container-image flag 제거, NodeConfig kubelet.flags, 골든 이미지에서 삭제
  • 1.36: containerd 2.0 이상 필요 (1.35가 containerd 1.x 마지막)
  • 1.36: gitRepo volume 비활성, StrictIPCIDRValidation 기본 활성, Service externalIPs deprecated
  • 업그레이드는 한 마이너씩, 이전 버전의 변경 사항도 모두 적용되므로 함께 점검

위 항목은 업그레이드 전에 끝낼 일입니다. 노드에서 확인하지 못했다면 새 호스트로 먼저 검증합니다.

제한망 ≠ 단절: AWS 연결은 필수

  • 제한망 = 퍼블릭 인터넷은 제한, 하지만 EKS 컨트롤 플레인과 자격 증명용 AWS 서비스 연결은 계속 필요
  • 물리적 단절(DDIL)은 Hybrid Nodes의 지원 운영 모델이 아님, IAM Roles Anywhere도 CreateSession 호출이 필요
  • 온프레미스에서 S3에는 Interface 엔드포인트 사용 (gateway 엔드포인트는 온프레미스에서 직접 접근 불가)
  • 소프트웨어는 승인한 manifest를 자체 미러에서 사용, artifact와 manifest는 검토한 절차로 직접 준비 (nodeadm은 SigV4 서명 없는 HTTP(S)로 다운로드)
sudo nodeadm install "$APPROVED_PATCH" --region "$REGION" \ --credential-provider iam-ra --containerd-source none \ --manifest-override "file://$LOCAL_MANIFEST" --private-mode sudo nodeadm init --config-source file:///etc/eks/nodeconfig.yaml \ --manifest-override file:///etc/eks/manifest.json --private-mode

--private-mode는 --manifest-override가 필수이며 OS 패키지 설치를 건너뜁니다. containerd, runc, iptables, CA 인증서는 미리 설치해 두세요.

hybrid-assets.eks.amazonaws.com을 Route 53 PHZ에서 S3로 CNAME 해도 투명 미러가 되지 않습니다.

  • TLS 인증서, SNI 호스트명 불일치
  • HTTP Host 헤더와 S3 버킷, 키 매핑 불일치
  • 요청 권한(서명) 미제공

TLS 검사를 끄는 방식으로 해결하지 않습니다. 대신 통제된 프록시, 사전 설치 이미지, 실제 미러 URL의 manifest override 중 선택하세요.

장애는 증상별로 좁혀 간다

sudo nodeadm debug --config-source file:///etc/eks/nodeconfig.yaml sudo journalctl -u kubelet --since '-15 min' --lines 200 --no-pager
  • 노드 IP가 EKS remote node CIDR 안에 있는가
  • DNS, 라우팅, TCP 443 반환 경로, 의도한 Hybrid 역할, HYBRID_LINUX access entry
  • 엔드포인트가 "Public and Private"로 설정되지 않았는가 (public IP로 해석되어 join 실패 가능)
  • eks:DescribeCluster 권한 여부
sudo systemctl status kubelet containerd --no-pager kubectl describe node "$NODE" kubectl -n kube-system get pods -o wide | grep cilium
  • CNI, agent 로그, 런타임, 디스크, 리소스 조건 확인
  • NotReady가 항상 CNI 누락 때문은 아님
  • NotReady만으로 등록 해제, 재초기화하지 않기 (nodeadm reset은 없음)
  • API → kubelet TCP 10250이 온프레미스 방화벽으로 들어오는가
  • Webhook은 실제 설정한 포트, Pod IP 경로가 열려 있는가
  • 이미지 풀/x509 오류: ECR api, dkr, S3, 레지스트리 CA와 호스트명 (TLS 검증 유지, curl -k 금지)
  • DNS: CoreDNS가 클라우드/온프레미스 양쪽에 있는지 확인
  • EKS cluster insights의 hybrid nodes 점검 항목도 함께 확인
openssl x509 -in "$CERT_PATH" -checkend 2592000 -noout sudo nodeadm debug --config-source file:///etc/eks/nodeconfig.yaml
  • SSM: 활성화 만료(신규 등록 제한)와 에이전트 갱신, 시각 동기화를 구분
  • IAM Roles Anywhere: 인증서 만료, 역할 세션 시간, AWS 접근 확인
  • sudo aws sts get-caller-identity는 kubelet이 쓰는 신원을 증명하지 않음

크리덴셜 만료를 먼저 감시하라

  • 활성화 기본 만료 24시간, 최대 30일, RegistrationLimit 1–1000
  • 활성화 만료는 신규 등록만 제한, 이미 등록한 노드는 영향 없음
  • 세션 자격 증명은 고정 1시간, 에이전트가 갱신
  • 새 호스트 등록이나 승인된 복구에만 새 활성화 생성
aws ssm create-activation --iam-role "$HYBRID_NODE_ROLE_NAME" \ --registration-limit "$NEW_NODE_COUNT" --region "$AWS_REGION" \ --output json > activation.private.json # 응답은 비공개 파일에 저장
  • 세션 기본 1시간, 범위 15분–12시간, 역할 MaxSessionDuration 이하
  • 노드 호스트 인증서 만료를 모니터링 (30일은 경고 임계값 예시)
# 만료까지 30일 미만이면 실패(종료 코드 1) openssl x509 -in "$CERT_PATH" -checkend 2592000 -noout
  • 인증서 갱신은 기존 PKI/CA 정책으로, 후보 인증서는 활성 파일과 분리 검증 후 교체
  • kubelet 재시작만으로 X.509가 갱신되지 않음

동일 CA에서 leaf만 갱신하면 trust anchor 교체는 보통 불필요합니다. CA rollover는 모든 호스트, profile, role에 영향을 줍니다.

jq -n --rawfile bundle "$APPROVED_CA_PEM" \ '{sourceType:"CERTIFICATE_BUNDLE", sourceData:{x509CertificateData:$bundle}}' \ > trust-anchor-source.private.json aws rolesanywhere update-trust-anchor --trust-anchor-id "$TRUST_ANCHOR_ID" \ --region "$AWS_REGION" --source file://trust-anchor-source.private.json

카나리 노드에서 새 자격 증명 발급을 검증한 뒤 마칩니다.

Block 3 Quiz (1/3)

Q1: nodeadm NodeConfig에서 반드시 직접 채워야 하는 최소 항목은?
Q2: nodeadm이 하이브리드 노드에 자동으로 붙여 주는 라벨은?

Block 3 Quiz (2/3)

Q3: nodeadm upgrade가 실패했을 때 올바른 대응은?
Q4: 제한망(air-gap)에서 비공개 manifest로 설치할 때 쓰는 옵션 조합은?

Block 3 Quiz (3/3)

Q5: EKS 1.37 kubelet에서 eventRecordQPS: 0의 의미는?

References & Q&A

nodeadm 레퍼런스
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-nodeadm.html
자격 증명
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-creds.html
Hybrid CNI
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-cni.html
Bottlerocket
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-bottlerocket.html
업그레이드, 릴리스 노트
docs.aws.amazon.com/eks/latest/userguide/hybrid-nodes-upgrade.html
docs.aws.amazon.com/eks/latest/userguide/kubernetes-versions-standard.html
nodeadm 소스
github.com/aws/eks-hybrid (v1.0.20)

운영, 워크로드, 보안 & 전략

Block 4: 배치, GPU, 관측성, 망분리 검토, 비용과 도입 판단

배치는 label 하나에서 시작한다

Hybrid 노드에는 eks.amazonaws.com/compute-type=hybrid label이 자동으로 붙습니다. 위치 label(example.com/location)은 노드 소유자가 직접 부여합니다.

nodeSelector: eks.amazonaws.com/compute-type: hybrid example.com/location: onprem tolerations: # hybrid taint를 쓰는 경우에만 필요 - key: eks.amazonaws.com/compute-type operator: Equal value: hybrid effect: NoSchedule
affinity: nodeAffinity: requiredDuringSchedulingIgnoredDuringExecution: nodeSelectorTerms: # term끼리 OR, term 안은 AND - matchExpressions: - {key: eks.amazonaws.com/compute-type, operator: In, values: [hybrid]} - {key: example.com/location, operator: In, values: [onprem]} - matchExpressions: - {key: example.com/location, operator: In, values: [cloud]} - {key: karpenter.sh/nodepool, operator: In, values: [cloud-burst-pool]} preferredDuringSchedulingIgnoredDuringExecution: - weight: 100 preference: matchExpressions: - {key: example.com/location, operator: In, values: [onprem]}

Hybrid taint는 선택 사항입니다. 자동으로 붙지 않으며, 추가 전에 CNI, DNS, GPU 인프라 Pod의 toleration부터 확인합니다.

kubectl taint node "$NODE_NAME" \ eks.amazonaws.com/compute-type=hybrid:NoSchedule

NoSchedule은 새 스케줄링에만 영향을 줍니다. label이나 required affinity를 바꿔도 이미 실행 중인 Pod는 자동으로 이동하지 않습니다.

topologySpreadConstraints: - maxSkew: 2 topologyKey: topology.kubernetes.io/zone whenUnsatisfiable: ScheduleAnyway labelSelector: matchLabels: app: hybrid-burst-app

ScheduleAnyway는 점수 선호이며 maxSkew를 넘을 수 있습니다. zone label은 실제 장애 도메인에만 부여하고, 모든 Hybrid 호스트를 AWS AZ로 표시하지 않습니다.

버스팅은 Pending Pod가 트리거

온프레미스 용량 부족
스케줄 불가 Pod
→
Pod = Pending
toleration 보유
→
Karpenter NodePool
requirements 매칭
→
EC2 노드 생성
cloud-burst-pool
→
Pod 스케줄
자동 복귀 없음
온프레미스 용량이 돌아와도 실행 중인 cloud Pod는 자동으로 돌아오지 않습니다.
포화 감지기가 아님
Karpenter는 조건에 맞는 Pending Pod에 반응합니다. 온프레미스 슬롯을 먼저 채우는 것도 보장하지 않습니다.
버전 요구
Kubernetes 1.36은 Karpenter 1.13 이상, 1.37은 1.15.x가 필요합니다.
막힐 수 있는 곳
AWS quota, 인스턴스 가용성, subnet IP, IAM, 노드 bootstrap, 워크로드 의존성.

스케일-인 순서는 선호일 뿐

1. 할당 상태
미할당 Pod가 할당된 Pod보다 먼저
2. Pod 단계
Pending, Unknown, Running 순서
3. Ready 여부
NotReady가 Ready보다 먼저
4. deletion cost
그 뒤에야 낮은 값이 먼저 제거
CREATE webhook은 비권장
CREATE 시점의 Pod에는 최종 노드(spec.nodeName)가 아직 없어 위치를 신뢰성 있게 알 수 없습니다.
대안: 스케줄 후 패치
바인딩 뒤 소유한 Pod 한 개에 annotation을 부여하고, UID, resourceVersion, nodeName을 test로 검사합니다.

GPU마다 할당 관리자는 하나

경로할당 방식
독립 NVIDIA device pluginnvidia.com/gpu 등 확장 리소스 게시
독립 DRA driverResourceSlice 게시, DeviceClass/ResourceClaim으로 할당
GPU Operator + ClusterPolicyOperator가 관리하는 device-plugin 방식
GPU Operator 26.7 + GPUCluster신규 설치용 Operator 관리 DRA, ClusterPolicy와 상호 배타적
DRA 권고
AWS는 신규 EKS 1.34 이상에 DRA를 권고합니다.
Auto Mode는 DRA 미지원
Auto Mode는 GPU device plugin을 자체 관리합니다.
확인한 버전
GPU Operator 26.7.0, DRA driver 0.5.0, device plugin 0.20.0
DRA 0.5.0 요구
K8s 1.34.2+, driver 565+, toolkit 1.18+, CDI. Operator 관리 DRA는 driver 580+

MIG는 격리, time-slicing은 공유

MIG는 GPU를 하드웨어 기반 compute, memory 인스턴스로 나눕니다. 아래는 A100 40 GB profile입니다.

Profile명목 메모리최대 인스턴스
1g.5gb5 GB7
2g.10gb10 GB3
3g.20gb20 GB2
4g.20gb20 GB1
7g.40gb40 GB1

4g.40gb는 A100 80 GB의 profile입니다. MIG 활성화, 재구성은 GPU 워크로드를 중단할 수 있는 유지보수 작업이며, Pod 요청만 nvidia.com/mig-1g.5gb로 바꿔도 인스턴스가 생기지 않습니다.

# device-plugin 설정 조각 (Kubernetes 리소스가 아님) version: v1 sharing: timeSlicing: renameByDefault: true failRequestsGreaterThanOne: true resources: - name: nvidia.com/gpu replicas: 4

renameByDefault: true이면 nvidia.com/gpu.shared로 게시됩니다. replica 4개는 독립 메모리 영역 4개가 아니며, replica 사이에 메모리, 장애 격리가 없습니다.

NVIDIA 사양H100 SXMH200 SXM
GPU 메모리80 GB HBM3141 GB HBM3e
메모리 대역폭3.35 TB/s4.8 TB/s
MIG최대 7개최대 7개

공급자 사양이며 이 환경의 실측값이 아닙니다. NVL/PCIe variant는 값이 다르므로 SXM 행을 모든 H100에 일반화하지 않습니다.

hybrid 지표는 relabel로 구분

apiVersion: monitoring.coreos.com/v1 kind: ServiceMonitor metadata: name: hybrid-node-exporter namespace: monitoring labels: release: kube-prom spec: # selector, namespaceSelector 생략 attachMetadata: node: true endpoints: - port: http-metrics relabelings: - sourceLabels: [__meta_kubernetes_node_label_eks_amazonaws_com_compute_type] regex: hybrid action: keep - targetLabel: compute_type replacement: hybrid
# GPU utilization (이미 percent) DCGM_FI_DEV_GPU_UTIL{compute_type="hybrid"} # GPU framebuffer 사용률: used / (used + free) 100 * DCGM_FI_DEV_FB_USED{compute_type="hybrid"} / (DCGM_FI_DEV_FB_USED{compute_type="hybrid"} + DCGM_FI_DEV_FB_FREE{compute_type="hybrid"})

node_cpu_seconds_total 등 호스트 지표는 kubelet이 아니라 Node Exporter가 제공합니다. DCGM exporter는 별도로 설치되어 있어야 합니다.

Hybrid에서는 cluster, workload, Pod, container 지표를 지원합니다. node-level 지표는 EC2 IMDS에 의존하는데 Hybrid 호스트에는 없어서 제공되지 않습니다. 호스트 CPU, 메모리는 Node Exporter와 Prometheus로 보완합니다.

Pod Identity 환경에서도 Hybrid 호환을 위해 RUN_WITH_IRSA 변수가 필요합니다. 기존 AmazonCloudWatchAgent의 spec.env 목록에 추가하고 기존 항목은 보존합니다.

# 기존 AmazonCloudWatchAgent.spec.env 목록에 항목 추가 - name: RUN_WITH_IRSA value: "True"

CoreDNS는 양쪽에 최소 1개

애드온이 설계의 배치
AWS Load Balancer Controllercloud node (webhook 접근, routable Hybrid IP target)
CloudWatch agent/operatoragent는 지원 노드, operator webhook은 cloud 권장
cert-managerwebhook cloud 권장, routable이면 Hybrid 가능
Metrics Servercloud 또는 도달 가능한 Hybrid Pod endpoint
Cilium/CalicoHybrid Node (cloud node는 VPC CNI 유지)

호환 기준이며 설치 target 버전이 아닙니다.

Add-onHybrid 호환 기준
Node monitoring agent1.2.0-eksbuild.1
External DNS0.19.0-eksbuild.1
FSx CSI1.7.0-eksbuild.1
Secrets Store provider2.1.1-eksbuild.1
Pod Identity Agent1.3.3-eksbuild.1 (Bottlerocket 1.3.7-eksbuild.2)
# CoreDNS Deployment.spec.template.spec 조각 nodeSelector: infrastructure.example.com/dns-eligible: "true" topologySpreadConstraints: - maxSkew: 1 minDomains: 2 topologyKey: example.com/location whenUnsatisfiable: DoNotSchedule labelSelector: matchLabels: k8s-app: kube-dns

적격 노드에 location 값 cloud 또는 onprem을 부여합니다. 한 도메인에 용량이 없으면 새 replica가 Pending일 수 있어 가용성 절충이며 failover 보장이 아닙니다.

외부 노출은 IP target과 BGP로

자체 관리형 AWS Load Balancer Controller는 도달 가능한 Hybrid Pod IP를 target으로 등록할 수 있습니다. ALB는 alb.ingress.kubernetes.io/target-type: ip, NLB는 service.beta.kubernetes.io/aws-load-balancer-nlb-target-type: ip와 loadBalancerClass: service.k8s.aws/nlb를 사용합니다.

route, 반환 경로, security group/firewall, remote Pod network 구성이 맞아야 합니다. 컨트롤러는 cloud node에 두는 설계를 권장합니다.

nodeSelector: example.com/location: cloud
apiVersion: cilium.io/v2 kind: CiliumLoadBalancerIPPool metadata: name: on-prem-pool spec: blocks: - cidr: "10.90.0.0/24" serviceSelector: matchLabels: exposure: onprem-bgp

예시 CIDR은 인벤토리에서 예약한 비중복 대역으로 바꿉니다. IP 할당이 라우터 광고나 통신 성공을 보장하지는 않습니다.

apiVersion: cilium.io/v2 kind: CiliumBGPAdvertisement metadata: name: hybrid-service-advertisement labels: advertise: hybrid-services spec: advertisements: - advertisementType: Service service: addresses: [LoadBalancerIP] selector: matchLabels: exposure: onprem-bgp

CiliumBGPClusterConfig, CiliumBGPPeerConfig와 함께 구성합니다. 세션, 수락된 라우트, next hop, 반환 경로를 확인해야 완성입니다.

cilium.io/v2 BGP CRD는 Cilium 1.18 기준입니다. 1.17.x 클러스터는 Block 2 예제처럼 v2alpha1을 사용합니다.

Cilium Ingress와 Gateway API는 L7 proxy가 필요합니다. 그러나 Hybrid Nodes Gateway의 필수 설정은 vtep.enabled=true, l7Proxy=false이므로 같은 Cilium 설치에 함께 적용할 수 없습니다. 기능을 켜기 전에 네트워크 설계를 먼저 선택합니다.

Pod Identity는 6단계 체크

  • (Ubuntu, RHEL, AL2023) 호스트 NodeConfig에 credentials file 활성화
    spec: hybrid: enableCredentialsFile: true
  • 호스트마다 계획된 nodeadm init을 다시 실행 (한 호스트씩 검증)
  • Pod Identity Agent add-on에 Hybrid DaemonSet 활성화
    {"daemonsets": {"hybrid": {"create": true}}}
  • add-on 버전 확인: 일반 OS 1.3.3-eksbuild.1 이상. Bottlerocket은 add-on 1.3.7-eksbuild.2 + OS 1.39.0 이상이며, 1–3 대신 bootstrap 명령에 --enable-credentials-file=true, DaemonSet 키는 hybrid-bottlerocket
  • eks-auth 서비스 경로 + 노드 역할의 eks-auth:AssumeRoleForPodIdentity 권한
  • 워크로드별 Pod Identity association (namespace, ServiceAccount, IAM role 신뢰, 권한)

'endpoint'는 세 가지를 뜻한다

Kubernetes API private endpoint
kubelet, Pod, 운영자가 TCP 443으로 접근하는 사설 진입점. control plane의 온프레미스행 연결을 없애지 않습니다.
EKS control-plane ENI
API server와 VPC, remote node/Pod network 사이의 연결 지점. DLP나 망연계 장비가 아닙니다.
interface VPC endpoint (PrivateLink)
eks, ssm, rolesanywhere 등 AWS 서비스 API용. kubelet 연결의 중계 서비스가 아닙니다.
세션 A: 노드가 시작 kubelet → API (TCP 443)
세션 B: API server가 시작 API → kubelet (TCP 10250), 사용 시 webhook 포트도 온프레미스 inbound
private endpoint ≠ 망분리 준수 노드가 먼저 연결했다는 이유로 control plane발 연결이 사라지지 않습니다.

망분리는 요건별로 따진다

고객 요구이 설계의 판단
인터넷 비노출, 승인된 사설 관리 통신 허용검토 가능한 후보 (증명 필요)
물리 단절, 외부 CP와 실시간 연결 불가연결 전제와 충돌
클라우드발 신규 연결 전면 금지kubelet, webhook 흐름과 충돌
업무 영역별 관리 주체, 권한 독립공통 cluster 관리자 범위 심사, 필요 시 cluster 분리
K8s 객체, Secret, 로그까지 온프레미스에만AWS control plane 구성과 충돌 가능

Direct Connect는 기본적으로 전송 중 암호화를 제공하지 않습니다. Kubernetes API, kubelet의 TLS와 인증을 유지하고, 회선 구간 암호화가 필요하면 IPsec over DX 또는 MACsec 적용 범위를 검토합니다.

MACsec은 지원 DX 연결의 링크 보호이며 종단 간 TLS와 범위가 다릅니다. Hybrid Nodes Gateway(VXLAN)도 자체 암호화가 없습니다.

get nodes/proxy를 단순 조회 권한으로 분류하지 않습니다. kubelet API를 통한 컨테이너 명령 실행이 가능할 수 있고, Kubernetes audit, admission 경로를 우회할 수 있습니다.

pods/log, pods/exec, pods/attach, pods/portforward, nodes/proxy와 workload 생성 권한을 함께 검토합니다.

다음은 준비할 증거 목록이며 점검 결과가 아닙니다.

심사 질문증거
private-only가 실제 적용됐는가endpoint 설정, DNS 응답, DX 경로, 경계 flow 기록
AWS에서 어디까지 접근 가능한가ENI/subnet, remote CIDR, route, SG, firewall 대응표
누가 어떤 API 작업을 했는가EKS audit 로그, CloudTrail
무엇이 망을 통과했는가VPC Flow Logs, 방화벽 기록

규제 대응은 증거로 말한다

AWS에 있는 것
Kubernetes API 객체 (Pod 사양, ConfigMap, Secret) 와 control-plane metadata. 노드 임시 자격 증명 발급도 AWS 서비스를 거칩니다.
온프레미스에 있는 것
워크로드 실행과 Pod가 처리하는 대용량 업무 데이터. 자동으로 AWS에 복제되지 않습니다.
경계를 넘을 수 있는 것
앱이 출력한 logs, 허가된 exec/cp/port-forward, 애플리케이션 egress, SSM 관리 경로.
"충족" 대신 "검토 범위와 조건" node selector나 label만으로 데이터 주권, 규정 준수가 입증되지 않습니다. 업무 데이터, API 객체, 로그, 이미지, 자격 증명을 각각 분류해 저장 위치와 조회 권한을 기록합니다.

비용은 vCPU-hour 구간 과금

월 사용량 구간 (vCPU-hour)요금
처음 576,000$0.020
다음 576,000$0.014
다음 4,608,000$0.010
다음 5,760,000$0.008
11,520,000 초과$0.006
노드월 vCPU-h연환산 노드 요금+ 클러스터 1개
10233,600$56,064$56,940
501,168,000$236,928$237,804
1002,336,000$377,088$377,964

가정: 노드당 32 vCPU, 월 730시간, 같은 월을 12번 반복, 표준 지원 클러스터 1개($0.10/시간) 포함. 청구서나 실측이 아닌 계산 모델입니다.

경쟁 솔루션 비교는 의도적으로 싣지 않았습니다 출처를 확인하지 못한 과거 추정치는 폐기했습니다. 하드웨어, 전력, OS 구독, 인력, 이전 비용이 포함된 자체 TCO 모델로 비교하세요.

도입 판단은 제약 확인부터

Hybrid Nodes가 맞는 신호
온프레미스 GPU, 대규모 로컬 데이터, edge 처리, 기존 하드웨어 활용. AWS와 안정적인 사설 양방향 연결을 유지할 수 있는 경우.
먼저 확인할 제약
IPv4만 지원. 간헐적, 단절(DDIL) 환경용이 아님. 연결이 끊기면 노드는 Unknown이 되고, toleration 없는 Pod는 기본 300초 뒤 eviction. GovCloud(US)와 중국 리전 제외. OS, 아키텍처, CNI 조합 확인.
맞지 않는 경우
완전 단절이 필요하거나 클라우드발 신규 연결이 전면 금지된 정책. AWS Region, Local Zone, Outposts, 타사 클라우드를 hybrid 인프라로 쓰는 것은 미지원.
운영 책임
Control plane은 AWS가 관리하지만 host, OS, 연결, workload 운영은 계속 사용자 책임입니다.
대안과의 비교 동등한 가용성, 지원 범위로 자체 TCO 모델을 만들어 비교하세요. 이 자료는 특정 대안의 우열을 주장하지 않습니다.

핵심 요약: 4개 블록, 6가지

1. 구조와 전제
AWS가 control plane을, 사용자가 host, 연결, workload를 운영합니다. AWS와의 사설 양방향 연결이 필수입니다.
2. 네트워크
kubelet 10250과 webhook은 AWS에서 시작하는 inbound입니다. Gateway는 선택이며 직접 라우팅도 유효합니다.
3. 라이프사이클
nodeadm으로 설치, join, 업그레이드합니다. rollback 명령이 없으므로 업그레이드, 복구 모두 in-place보다 호스트 교체를 우선합니다.
4. 워크로드 배치
compute-type label로 배치하고, 버스팅은 Pending Pod가 트리거하며 자동 복귀는 없습니다.
5. GPU와 관측성
GPU마다 할당 관리자는 하나, 신규 1.34 이상은 DRA 권고. hybrid 지표는 relabel로 구분합니다.
6. 보안과 비용
private endpoint는 망분리 준수의 증거가 아닙니다. 비용은 보고된 vCPU-hour 구간 과금입니다.

Knowledge Check (1/2)

Q1: Karpenter 클라우드 버스팅의 트리거는 무엇인가요?
Q2: 하나의 물리 GPU에 대한 설명으로 맞는 것은?

Knowledge Check (2/2)

Q3: pod-deletion-cost에 대한 설명으로 맞는 것은?
Q4: "private endpoint를 쓰므로 망분리를 준수한다"는 주장은?

참고 자료 & Q&A

AWS 공식 문서
docs.aws.amazon.com/eks/latest/userguide/
hybrid-nodes-overview.html
hybrid-nodes-networking.html
hybrid-nodes-add-ons.html
hybrid-nodes-webhooks.html
hybrid-nodes-gateway-cni.html
GPU
docs.aws.amazon.com/eks/latest/userguide/
device-management-nvidia.html
NVIDIA GPU Operator 문서 (platform-support)
비용, 스케줄링
aws.amazon.com/eks/pricing/
karpenter.sh/docs/upgrading/compatibility/
kubernetes.io ReplicaSet pod-deletion-cost
Q&A 이 자료의 예제는 검토 기준(EKS 1.36, nodeadm 1.0.20)이며 대부분 실제 클러스터에서 실행한 결과가 아닙니다. 적용 전 최신 AWS 문서로 지원 조합을 확인하세요.

Thank You

운영, 워크로드, 보안 & 전략, 감사합니다

수고하셨습니다!

← 목차로 돌아가기